Make Time

Ce que tu vas apprendre
- Agent Harness : le concept et pourquoi c'est plus important que le modèle que tu utilises
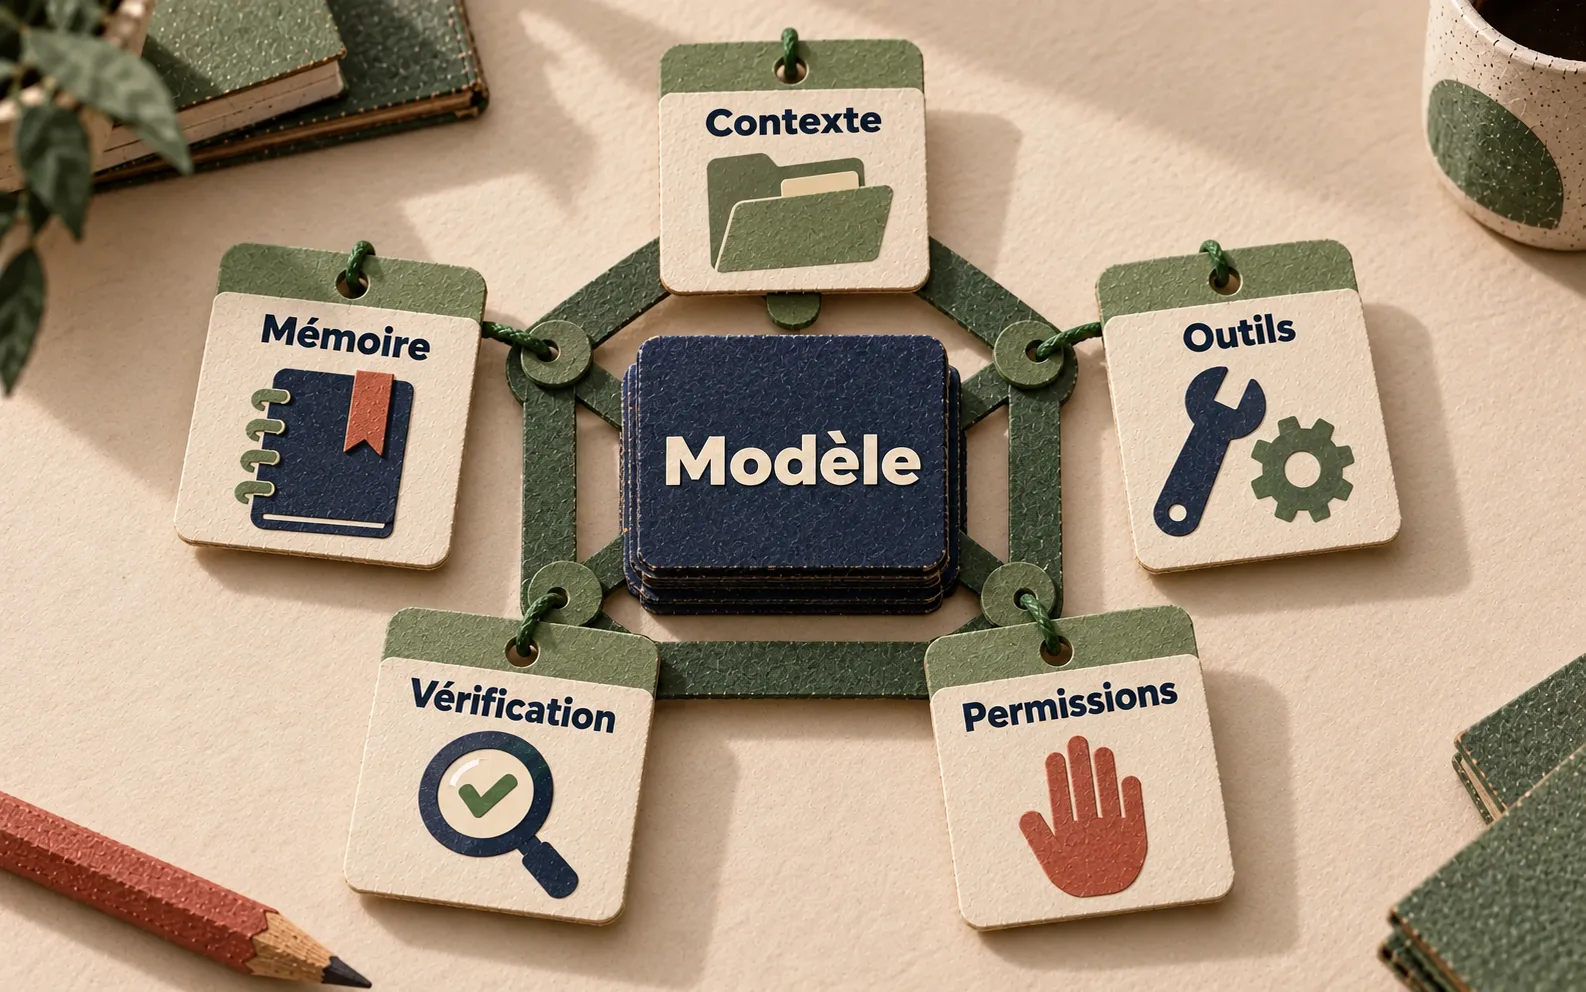
- Les 5 briques d'un harness : contexte, mémoire, outils, vérification et permissions, avec Claude Code et Codex en exemples
- La boucle d'agent : ce qui se passe entre ta demande et le résultat
- La Bitter Lesson : pourquoi Vercel a supprimé 80% des outils de son agent et obtenu de meilleurs résultats
- Context Engineering : l'évolution naturelle du Prompt Engineering, et le rôle central du Harness
- 3 principes concrets pour construire un Harness qui survit aux mises à jour des modèles
Agent Harness : infrastructure logicielle qui entoure un modèle IA pour orchestrer des tâches longues. Le Harness gère le cycle de vie de l'agent (, outils, hooks), optimise l'utilisation du contexte et assure la fiabilité sur des centaines d'appels d'outils. C'est l'équivalent d'un système d'exploitation pour .
01 LE CARNET / 1 MIN
Le constat : le modèle ne suffit plus
Si tu as lu mon Build in Public #12, tu sais que j'ai audité Sam Tennis intégralement depuis mon . La bonne nouvelle : le workflow a fonctionné. Des dizaines de requêtes PostHog via MCP, des analyses de , des croisements de données sur la rétention. Le tout sans ouvrir un seul dashboard.
La mauvaise nouvelle : ce n'est pas le modèle qui a fait la différence. C'est tout ce qu'il y a autour. Mes fichiers de contexte, mes connexions , mon architecture BMAD, mes règles de code. Si j'avais donné la même tâche au même modèle dans un chat vide, il aurait perdu le fil après 5 minutes.
En janvier 2026, Philipp Schmid a publié un article qui met un nom sur cette réalité : l'Agent Harness. Et c'est un concept que tout Vibe Coder devrait connaître.
02 LE CARNET / 1 MIN
Le concept : ton Cursor est un système d'exploitation
L'analogie qui clarifie tout
Schmid utilise une analogie informatique simple et efficace :
- Le Modèle (Claude, GPT, Gemini) = le CPU. La puissance brute de calcul.
- La fenêtre de contexte = la RAM. La mémoire de travail, limitée et volatile.
- L'Agent Harness = le Système d'Exploitation. Il gère le contexte, lance la séquence de démarrage (prompts, hooks), fournit les drivers (gestion des outils).
- L'Agent = l'Application. Ta logique métier qui tourne par-dessus.
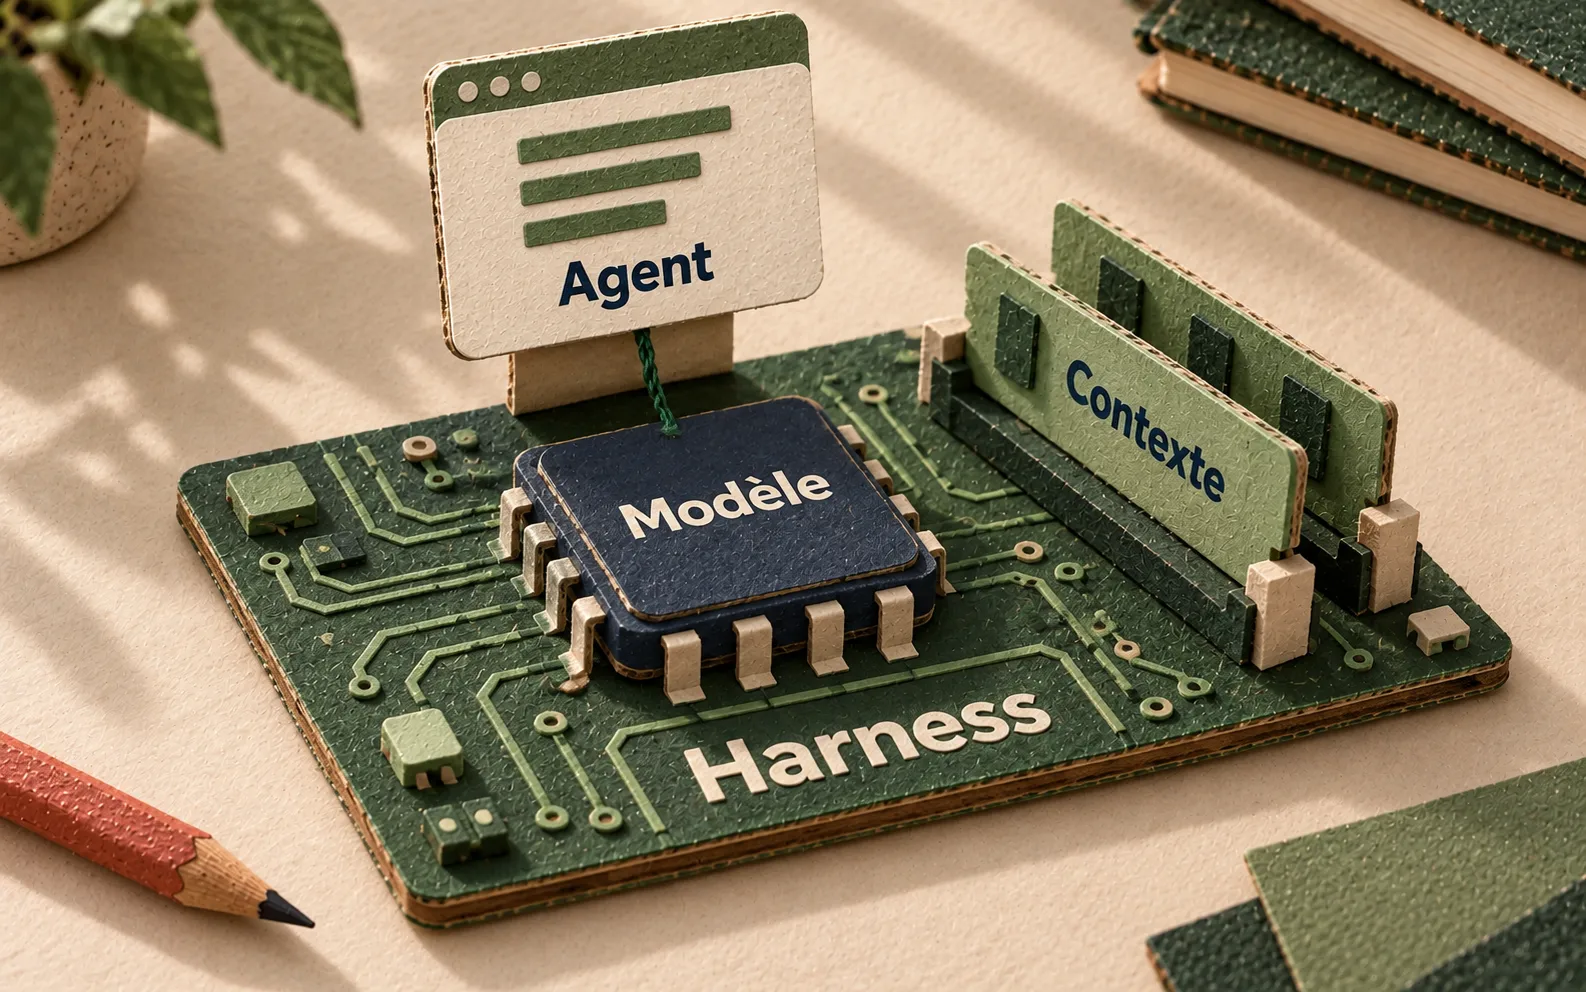
Tu ne juges pas un ordinateur uniquement sur son CPU. Un processeur puissant avec un OS instable, c'est inutile. C'est la même chose avec l'IA : un modèle performant dans un environnement mal structuré va halluciner, dériver et perdre le contexte.
Claude Code : le premier Harness grand public
Claude Code est l'exemple le plus concret d'Agent Harness aujourd'hui. Ce n'est pas juste un chat avec un modèle. C'est une infrastructure complète :
- Persistance du contexte entre les sessions
- Exécution d'outils (système de fichiers, terminal, recherche)
- Gestion des sous-agents pour les tâches complexes
- Hooks de cycle de vie (pré/post exécution)
Schmid va plus loin : tous les coding CLIs sont des Agent Harnesses spécialisés. Cursor, Windsurf, Cline, Aider... Chacun implémente sa propre façon de gérer le contexte, d'orchestrer les outils et de maintenir la cohérence sur la durée.
La différence entre un bon et un mauvais setup dans Cursor, c'est la qualité de ton Harness personnel : tes fichiers .md, ton .cursorrules, tes connexions MCP. Le modèle est le même pour tout le monde. L'infrastructure autour, c'est la tienne.
Côté OpenAI, Codex joue le même rôle autour des modèles GPT. C'est le point que beaucoup ratent : Claude Code et Codex ne sont pas des modèles, ce sont des harness. Place le même modèle dans un autre harness et il ne donnera pas les mêmes résultats, parce qu'il ne recevra ni le même contexte, ni les mêmes outils, ni les mêmes garde-fous. J'utilise les deux au quotidien, et je te montre Codex en détail dans mon guide Codex.
03 LE CARNET / 2 MIN
Les 5 briques d'un harness
Un modèle seul ne sait faire qu'une chose : prédire la suite d'un texte. Il ne se souvient de rien d'une session à l'autre, il ne voit pas tes fichiers, il ne peut rien faire lui-même et il ne vérifie pas son travail. Tout le reste, c'est le harness qui l'apporte, et on peut le découper en cinq briques.
1. Le contexte
Chaque session démarre avec un modèle qui ne sait rien de ton projet. Le harness lui donne, avant même ta première demande, ce qu'il doit savoir : la structure du projet, tes conventions, les commandes à lancer, les dossiers à ne pas toucher.
Dans Claude Code, ce rôle revient au fichier CLAUDE.md, chargé au début de chaque session. Codex lit AGENTS.md au démarrage : le fichier global, puis ceux du projet, de la racine jusqu'au dossier où tu travailles, et les consignes les plus proches l'emportent. Claude Code sait d'ailleurs lire un AGENTS.md existant à la place de CLAUDE.md.
C'est la brique la plus rentable : tu l'écris une fois, elle sert à chaque session. Les Skills vont plus loin en ne chargeant du contexte que lorsqu'une tâche en a besoin. Attention quand même : ces fichiers restent des consignes. Pour interdire vraiment une action, il faut passer par les permissions, la cinquième brique.
2. La mémoire
La fenêtre de contexte d'un modèle est limitée. Plus la session avance, plus elle se remplit, et plus les consignes du début se diluent : c'est le model drift, dont je parle plus bas.
La parade s'appelle la compaction : le harness résume ce qui s'est passé (l'objectif, les fichiers modifiés, les erreurs, les pistes abandonnées) en une version courte, et la session repart sur cette base. Claude Code la déclenche tout seul quand c'est nécessaire, ou à ta demande avec /compact. Après une compaction, il relit ton CLAUDE.md pour ne pas perdre tes consignes.
Il y a aussi la mémoire d'une session à l'autre. Claude Code tient une mémoire automatique : il note lui-même ce qu'il apprend de tes corrections, dans un dossier dédié dont l'index, MEMORY.md, est chargé à chaque session (les 200 premières lignes).
3. Les outils
Un modèle ne produit que du texte. Pour qu'il agisse, le harness repère dans sa réponse une demande précise, comme « lis ce fichier » ou « lance cette commande », l'exécute, puis lui renvoie le résultat. Ce va-et-vient se répète des dizaines de fois pendant une tâche, sans que tu le voies.
Pour brancher de nouveaux outils, le standard s'appelle MCP, pour Model Context Protocol. Sa documentation le compare à un port USB-C pour les applications IA : une seule prise pour connecter ton agent à Notion, à une base de données ou à Apify pour aller chercher de la donnée sur le web. Et n'importe qui peut construire un serveur MCP : c'est un bon premier projet à faire avec ton agent.
4. La vérification
Laissé seul, un modèle relit son travail et le trouve très bien. Il ne sait pas si son code tourne, si sa page s'affiche ou si son calcul est juste.
Le harness lui donne de quoi vérifier : lancer les tests, le linter, le build, faire une capture de la page, puis lire le résultat. Si ça échoue, l'agent corrige et recommence. C'est aussi pour ça qu'un bon agent ne calcule pas de tête : il écrit trois lignes de code et lit la réponse.
Sur Sam Tennis, je fais passer les builds de l'app par EAS Build, avec le connecteur Expo de Codex, pour vérifier que toutes les specs sont respectées.
5. Les permissions
Dernière brique : ce que l'agent a le droit de faire sans te demander. Supprimer un dossier, envoyer des données vers un site inconnu, pousser du code : certaines actions méritent ton feu vert.
Claude Code propose plusieurs modes, du plus prudent au plus libre. Par défaut, il ne fait que lire sans te demander. En acceptEdits, il modifie aussi les fichiers. En mode auto, un second modèle passe en revue les actions à ta place. Et bypassPermissions laisse tout passer : il est réservé aux conteneurs et aux machines virtuelles isolés. Codex fonctionne de la même façon, avec un bac à sable (lecture seule, écriture dans le projet ou accès complet) et une règle qui dit quand il doit te demander. De mon côté, je travaille dans Codex avec le mode « Approuver à ma place ».
Deux outils complètent le tableau :
- Les hooks : des scripts qui se déclenchent à des moments précis. Un hook placé avant une commande peut la bloquer (un
rm -rf, par exemple), un hook placé après une modification peut formater le code ou lancer les tests. - Le bac à sable : une frontière posée par le système d'exploitation autour des commandes de l'agent. Elles n'écrivent que dans le dossier du projet et les dossiers que tu ajoutes, et ne sortent sur le réseau que vers les domaines que tu autorises. Attention si tu es sur Windows comme moi : le bac à sable de Claude Code tourne sur macOS, Linux et WSL2, pas sous Windows natif.
04 LE CARNET / 1 MIN
La boucle d'agent
Une fois les cinq briques en place, l'agent travaille en boucle :
- Réfléchir : le modèle lit le contexte et l'état actuel, puis choisit la prochaine étape.
- Agir : il demande un outil, par exemple lire un fichier ou lancer une commande.
- Contrôler : le harness vérifie que l'action est autorisée.
- Exécuter : l'action tourne, dans le bac à sable quand il y en a un.
- Lire : le harness renvoie au modèle la partie utile du résultat, et tout recommence.
La boucle s'arrête quand l'objectif est atteint, ou quand l'agent a besoin de toi. Ce schéma vient d'un article de recherche de 2022, ReAct (pour « Reason » et « Act »), qui proposait de faire alterner raisonnement et actions. La plupart des agents actuels suivent encore ce principe.
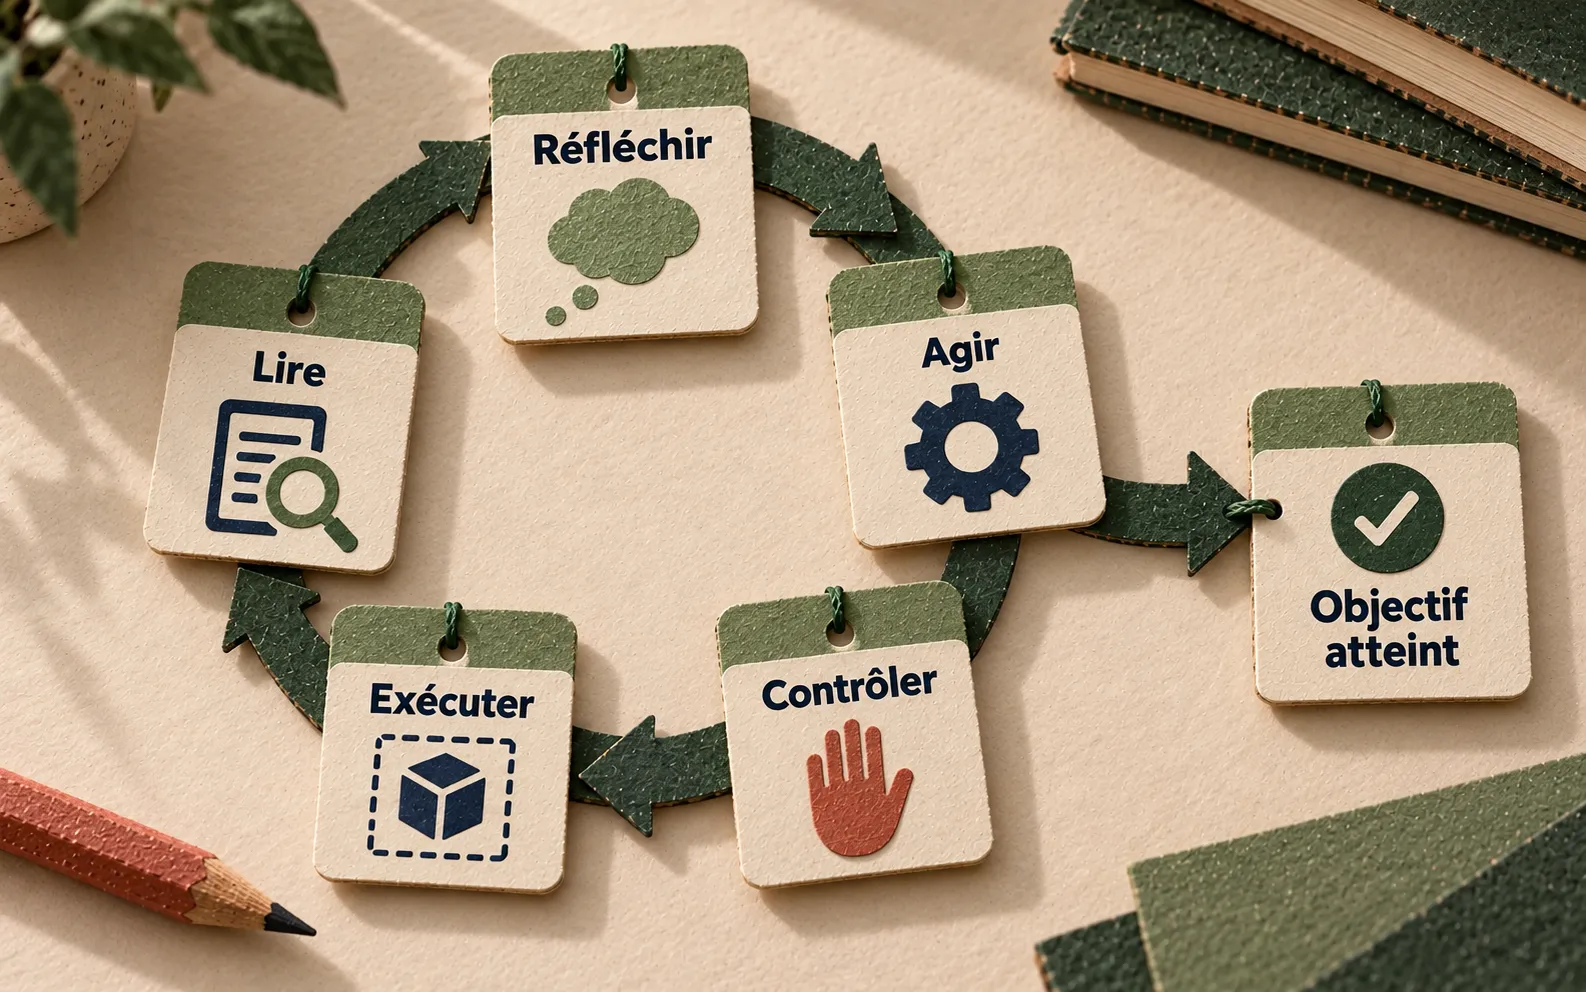
Cette boucle tourne à l'intérieur d'une tâche. Les loops dont je parle dans cet article se placent un cran au-dessus : c'est toi qui conçois une boucle autour de l'agent, avec un objectif et une façon de mesurer s'il est atteint.
05 LE CARNET / 1 MIN
Le vrai problème : la durabilité, pas l'intelligence
Pourquoi les benchmarks sont trompeurs
On passe notre temps à comparer les modèles sur des leaderboards. Claude bat GPT sur SWE-Bench. GPT reprend l'avantage sur AIME. Gemini surpasse les deux sur le multimodal. Les écarts entre les modèles de tête se resserrent à chaque release.
Mais ces benchmarks mesurent des tâches courtes. Un puzzle à résoudre en un ou deux essais. Personne ne teste ce qui se passe après le 50e appel d'outil. Personne ne mesure si le modèle suit encore tes instructions initiales après une heure de travail continu.
C'est la durabilité : la capacité d'un modèle à rester fiable, cohérent et aligné sur la durée. Et c'est exactement ce que les benchmarks actuels ne capturent pas.
Le model drift : le bug invisible
Le scénario classique : tu démarres une session Cursor. Les 20 premières minutes, tout est parfait. Le modèle respecte tes conventions, utilise les bons patterns, suit ton architecture. Et puis, petit à petit, il commence à dériver. Il oublie une règle. Il réintroduit un pattern que tu avais interdit. Il invente un import qui n'existe pas.
C'est le model drift. Plus la tâche est longue, plus le risque augmente. Un Agent Harness bien conçu combat ce phénomène en :
- Compactant le contexte : résumer les étapes passées pour libérer de la "RAM"
- Isolant les tâches : déléguer à des sous-agents avec un contexte frais
- Réinjectant les instructions critiques : rappeler les règles à intervalles réguliers
C'est exactement le rôle de mes fichiers tech_rules.md et .cursorrules sur Sam Tennis. Ils ne sont pas là pour expliquer des concepts au modèle. Ils sont là pour l'empêcher de dériver.
06 LE CARNET / 1 MIN
La Bitter Lesson : pourquoi la simplicité gagne toujours
Le principe
Rich Sutton a écrit un essai célèbre en IA : The Bitter Lesson. Sa thèse : les méthodes générales qui exploitent la puissance de calcul battent systématiquement le savoir codé en dur par des humains.
Appliqué aux agents IA, la leçon est brutale : chaque pipeline complexe, chaque logique de contrôle codée en dur, chaque garde-fou artisanal que tu construis aujourd'hui sera rendu obsolète par la prochaine mise à jour du modèle.
Les preuves en 2026
Vercel a publié un cas d'étude sur leur agent text-to-SQL interne. Ils avaient construit 16 outils spécialisés : validation de schéma, récupération d'erreurs, clarification d'intention, validateurs de syntaxe. Le système marchait, mais il était fragile et lent.
Leur décision : supprimer 80% des outils et donner au modèle un accès direct aux fichiers bruts via le terminal.
Les résultats :
- Taux de réussite : de 80% à 100%
- Temps de réponse : divisé par 3,5 (de 274s à 77s)
- Consommation de : -37%
- Nombre d'étapes : -42%
Moins d'outils, moins de contrôle, de meilleurs résultats. La Bitter Lesson en action.
Vercel n'est pas un cas isolé :
- Manus a refactorisé son Harness 5 fois en 6 mois pour supprimer des hypothèses rigides
- LangChain a reconstruit son agent "Open Deep Research" 3 fois en un an
Ce que ça m'a appris sur mon propre setup
En relisant ma propre évolution sur Make Time, je retrouve la même trajectoire :
- BIP #2 : je donnais des prompts de 200 lignes avec des instructions ultra-détaillées. Résultat moyen.
- BIP #10 : j'ai externalisé tout ça dans des fichiers Markdown + connexion MCP Notion. Le code généré s'est amélioré immédiatement.
- File Engineering : j'ai appris à être concis. Réduire
tech_stack.mdde 120 à 35 lignes a augmenté la qualité. Moins de bruit, plus de signal. - BIP #11 : la méthode BMAD m'a appris à laisser l'IA planifier au lieu de tout lui dicter.
À chaque étape, j'ai retiré du contrôle. Et à chaque étape, les résultats se sont améliorés. La Bitter Lesson, appliquée à mon scale de Solo Builder.
07 LE CARNET / 1 MIN
Les 3 principes : construire ton Agent Harness
Schmid conclut son article avec trois principes. Je les reprends ici avec mon interprétation pratique.
Principe 1 : Start Simple (Commence simple)
Ne construis pas de systèmes de contrôle massifs. Fournis des outils atomiques et robustes. Laisse le modèle faire le plan. Implémente des garde-fous, des retries et des vérifications.
En pratique dans Cursor :
- Un fichier
tech_stack.mdconcis (35 lignes max) - Un
.cursorrulesavec tes conventions de code - Le MCP connecté aux outils que tu utilises vraiment (PostHog, Supabase, Notion)
- Pas de pipeline complexe entre toi et le modèle
C'est contre-intuitif. On a envie de tout cadrer, tout contrôler. Mais le message de Vercel est clair : le modèle avec accès aux données brutes surpasse le modèle emprisonné dans 16 outils spécialisés.
Principe 2 : Build to Delete (Construis pour supprimer)
Rends ton architecture modulaire. Chaque nouveau modèle va rendre une partie de ta logique obsolète. Tu dois pouvoir supprimer du code sans tout casser.
C'est exactement ce que j'ai vécu avec la méthode BMAD. Quand j'ai structuré Sam Tennis V2 avec des agents spécialisés (PM, Architecte, Dev, QA), j'ai découpé le système en modules indépendants. Quand Claude a amélioré sa gestion du contexte entre deux releases, j'ai pu supprimer un module de planification manuelle sans toucher au reste.
La règle : si tu ne peux pas supprimer un composant de ton setup en moins d'une heure, ton architecture est trop couplée.
Principe 3 : The Harness is the Dataset (Le Harness est le jeu de données)
C'est le principe le plus stratégique. L'avantage compétitif n'est plus dans le prompt. Il est dans les trajectoires que ton Harness capture.
Chaque fois que ton agent échoue à suivre une instruction en fin de session, c'est une donnée. Chaque dérive du modèle, chaque hallucination, chaque correction que tu apportes dans ton fichier rules.md enrichit ton Harness.
C'est la boucle feedback que j'ai décrite dans le guide File Engineering : à chaque bug résolu, tu demandes à l'IA "Comment aurais-je dû formuler ma demande pour éviter ce problème ?". La réponse va dans rules.md. Ton système s'améliore à chaque erreur.
Au bout de 12 chapitres de Build in Public, mon Harness personnel contient des dizaines de règles apprises par l'expérience. Personne ne peut copier ça. Ces règles encodent mes erreurs, mes projets, mes contraintes. C'est un avantage compétitif organique.
08 LE CARNET / 1 MIN
Ce qui arrive ensuite
Le modèle progresse, mais le harness aussi, et une bonne partie des progrès récents des agents vient de ce qui entoure le modèle. Trois tendances à suivre :
- MCP partout. Les assistants comme Claude et ChatGPT se branchent désormais à des services externes par MCP. Chaque nouveau serveur élargit ce que ton agent sait faire, sans attendre un nouveau modèle.
- Des équipes d'agents. Claude Code teste des équipes d'agents : une session principale répartit le travail entre plusieurs coéquipiers, chacun avec son propre contexte, qui partagent une liste de tâches et s'envoient des messages. La documentation cite un usage parlant : lancer plusieurs agents sur des hypothèses concurrentes et leur demander de se contredire, pour garder l'explication qui résiste. C'est encore expérimental, et ça consomme nettement plus de tokens qu'une session seule.
- Des harness qui apprennent de leurs erreurs. Chaque erreur de l'agent peut servir à corriger le harness lui-même : une règle de plus dans
CLAUDE.md, un hook, un test. C'est le principe « le Harness est le jeu de données » vu plus haut, et l'idée derrière AutoResearch, où un seul fichier Markdown dirige des centaines d'expériences.
09 LE CARNET / 1 MIN
Conclusion : Le Harness, pas le modèle
Le prochain modèle qui sortira sera meilleur. Et celui d'après aussi. Les benchmarks vont continuer à s'améliorer. Mais si tu passes ton temps à choisir entre Claude et GPT au lieu de structurer ton environnement de travail, tu optimises le mauvais paramètre.
L'article de Schmid cristallise ce que j'ai constaté sur mes propres projets depuis un an : le Context Engineering a remplacé le Prompt Engineering. Le fichier .md bien structuré bat le prompt parfait. Le MCP connecté bat le copier-coller de données. L'architecture modulaire bat le monolithe hyper-optimisé.
Pour les Solo Builders, c'est une bonne nouvelle. Tu n'as pas besoin de l'infrastructure de Google pour construire un bon Harness. Tu as besoin de fichiers Markdown, d'un IDE connecté et de la discipline de documenter tes erreurs. C'est une compétence accessible. Et c'est celle qui fera la différence en 2026.
À très vite, Guillaume 👋
10 LE CARNET / 1 MIN
Questions fréquentes
C'est quoi un Agent Harness exactement ?
Un Agent Harness est l'infrastructure logicielle qui entoure un modèle IA pour gérer les tâches longues et complexes. Il gère les prompts, les outils, le cycle de vie de l'agent et optimise le contexte. L'analogie la plus claire : si le modèle est le CPU d'un ordinateur, l'Agent Harness est le système d'exploitation. Le concept a été formalisé par Philipp Schmid en janvier 2026.
Claude Code et Codex sont-ils des harness ?
Oui. Claude Code est le harness d'Anthropic autour des modèles Claude, Codex celui d'OpenAI autour des modèles GPT. Ils apportent au modèle le contexte (CLAUDE.md, AGENTS.md), la mémoire, les outils, la vérification et les permissions. Un même modèle ne donne pas les mêmes résultats selon le harness qui l'entoure.
Quelles sont les briques d'un harness IA ?
Cinq briques : le contexte (ce que l'agent sait au démarrage), la mémoire (résumer la session et retenir ce qui compte d'une fois sur l'autre), les outils (agir, notamment via MCP), la vérification (tests, build, captures) et les permissions (ce que l'agent peut faire sans te demander, avec les hooks et le bac à sable).
Est-ce que Cursor est un Agent Harness ?
Oui. Cursor est un Agent Harness spécialisé pour le développement logiciel. Il gère le contexte (fichiers .md, .cursorrules), orchestre les outils (terminal, système de fichiers, MCP), et maintient la cohérence entre les sessions. La qualité de ton Harness Cursor dépend directement de la structure de tes fichiers de contexte et de tes connexions MCP. J'en parle en détail dans le guide File Engineering.
Quelle est la différence entre Context Engineering et Prompt Engineering ?
Le Prompt Engineering se concentre sur la formulation des instructions (le "comment dire"). Le Context Engineering se concentre sur la gestion de toutes les informations que le modèle reçoit (le "quoi donner") : prompts, mémoire, outils, données récupérées, historique. C'est un niveau d'abstraction au-dessus. Structurer un fichier tech_stack.md de 35 lignes chirurgicales, c'est du Context Engineering. Formuler un prompt parfait, c'est du Prompt Engineering. Le premier a plus d'impact que le second.
Comment je construis mon propre Agent Harness dans Cursor ?
Commence par 3 fichiers à la racine de ton projet : tech_stack.md (tes technologies, 35 lignes max), rules.md (les conventions de code), et tasks.md (les tâches en cours). Connecte au moins un MCP (Supabase, Notion, ou PostHog). Applique la boucle feedback : après chaque bug, mets à jour rules.md avec la leçon apprise. En quelques semaines, ton Harness connaîtra les subtilités de ton projet. Le processus complet est dans mon Build in Public #10.
11 LE CARNET / 1 MIN
Pour aller plus loin
- File Engineering : Le Guide d'Anthropic qui change tout
- Guide Cursor 2026 : de l'idée au code
- Protocol MCP : connecter l'IA à tes données
- Codex ChatGPT : le guide pour débuter
- Les loops : ne prompte plus tes agents IA
- Guide Skills Claude 2026
- Méthode BMAD : structurer le Vibe Coding
- Guide PostHog : comprendre tes utilisateurs
- Source originale : "The importance of Agent Harness in 2026" (Philipp Schmid)